 物界前沿

10份资料里找最终版,DeepSeek Harness给了出处,还是写错一条

整理资料时,最麻烦的一种错误,是它把结论和出处一起写得很完整,看上去像已经核对过。
我这次就碰到了一条。
DeepSeek Harness在结果里写:
09-04、09-07两场会议记录沿用同一批成员口径(MTG-02行3、MTG-03行3,均未另列参会名单)。
我打开它引用的两份原文件。两处第3行写的都是会议日期,根本没有参会名单。
9月2日那份会议记录确实列了4个人,但这不能证明9月4日和9月7日还是这4个人。
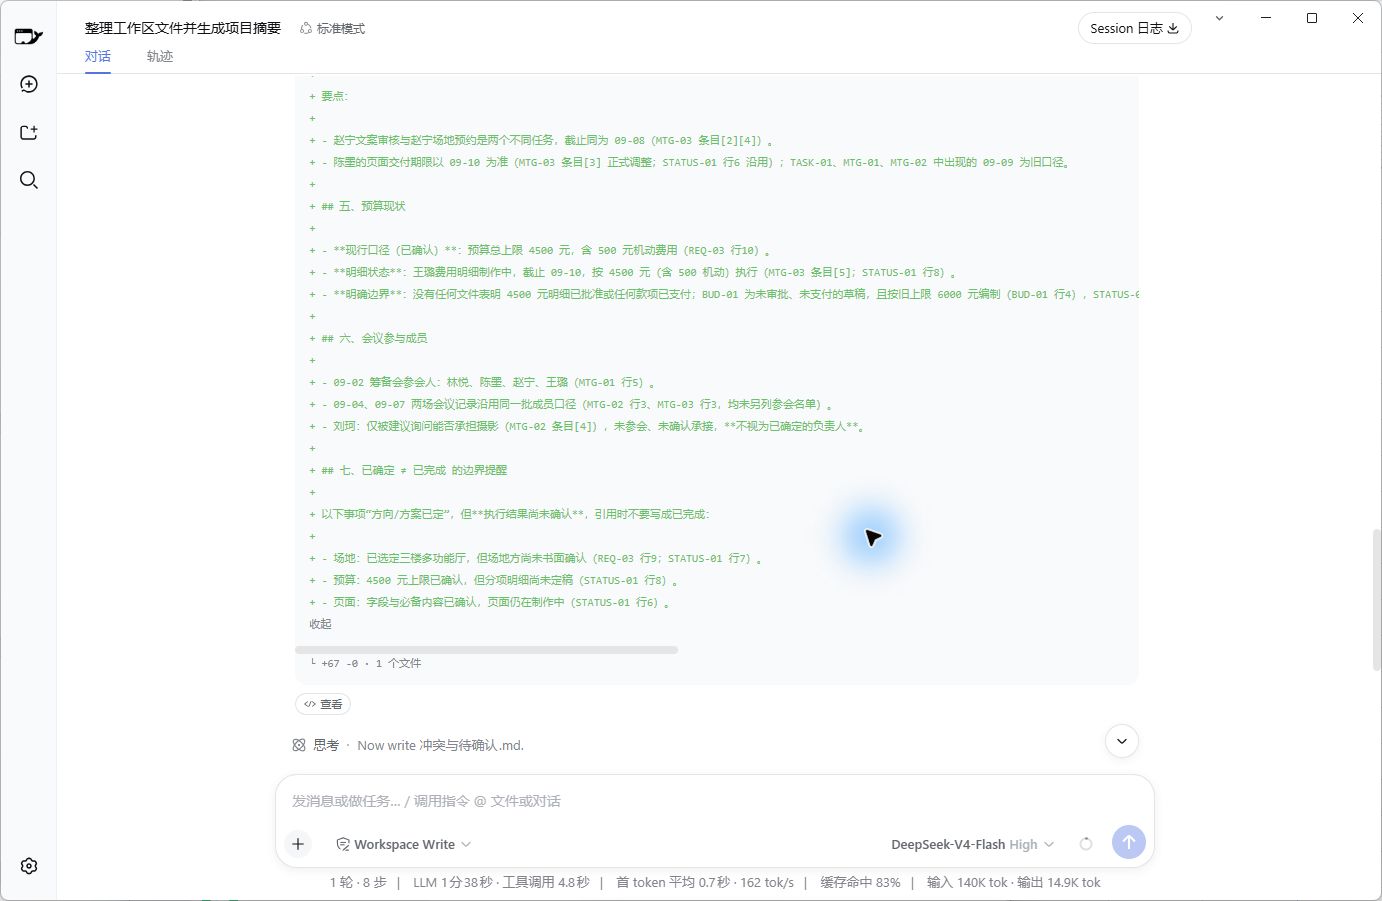
图1|这是本轮真实操作记录。图中“沿用同一批成员口径”没有得到所引原文的支持。
这句话应该改成:
9月2日的参会名单已经列明;9月4日和9月7日的记录没有列出完整参会名单,无法确认是否相同。
这篇就讲这一件事:AI给了出处以后,我怎么判断这句话能不能用。
有出处,不代表出处支持整句话
这次使用的是上一篇那10份模拟项目资料。里面有3版需求、3份会议记录,还有旧任务表、进度更新、场地备选和预算草稿。
材料是模拟的,人物和事项是虚构的。操作、生成文件和截图都来自这次真实运行。
我给DeepSeek Harness的详细任务里,已经写了两条要求:
• 每项事实附来源文件和可以定位的条目。
• 不要补造缺失信息,不要把建议写成决定。
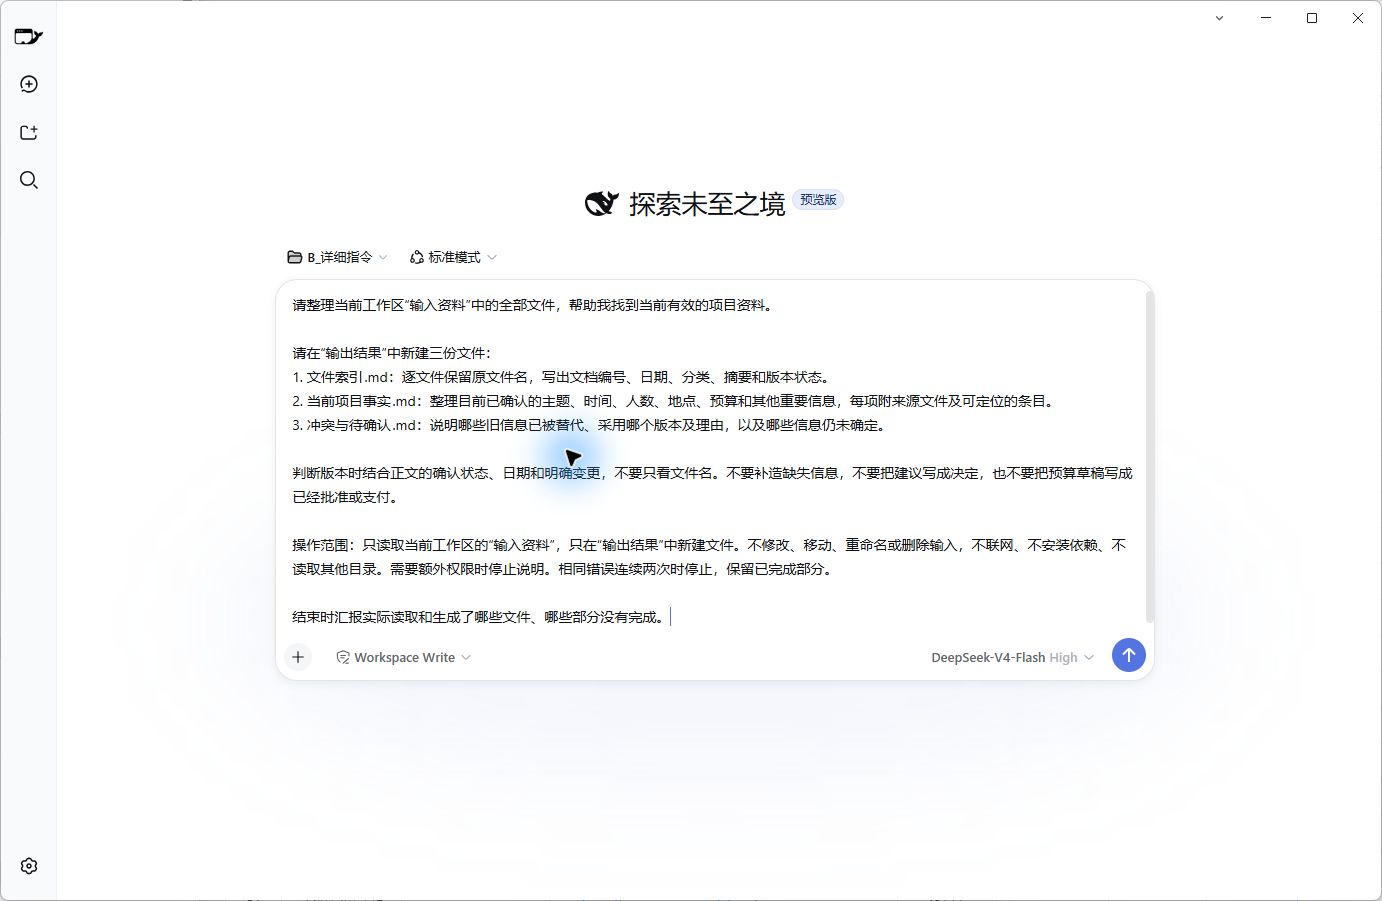
图2|实际发送的任务。模型为DeepSeek-V4-Flash,推理等级High,工作区写入模式。
它读完10份文件,按要求生成了3份结果:文件索引、当前项目事实、冲突与待确认。
时间、人数、预算、场地这些主要信息,它处理得基本正确。例如预算采用4500元,并保留“包含500元机动费用”;场地写成选定三楼多功能厅,同时注明尚未取得书面确认。
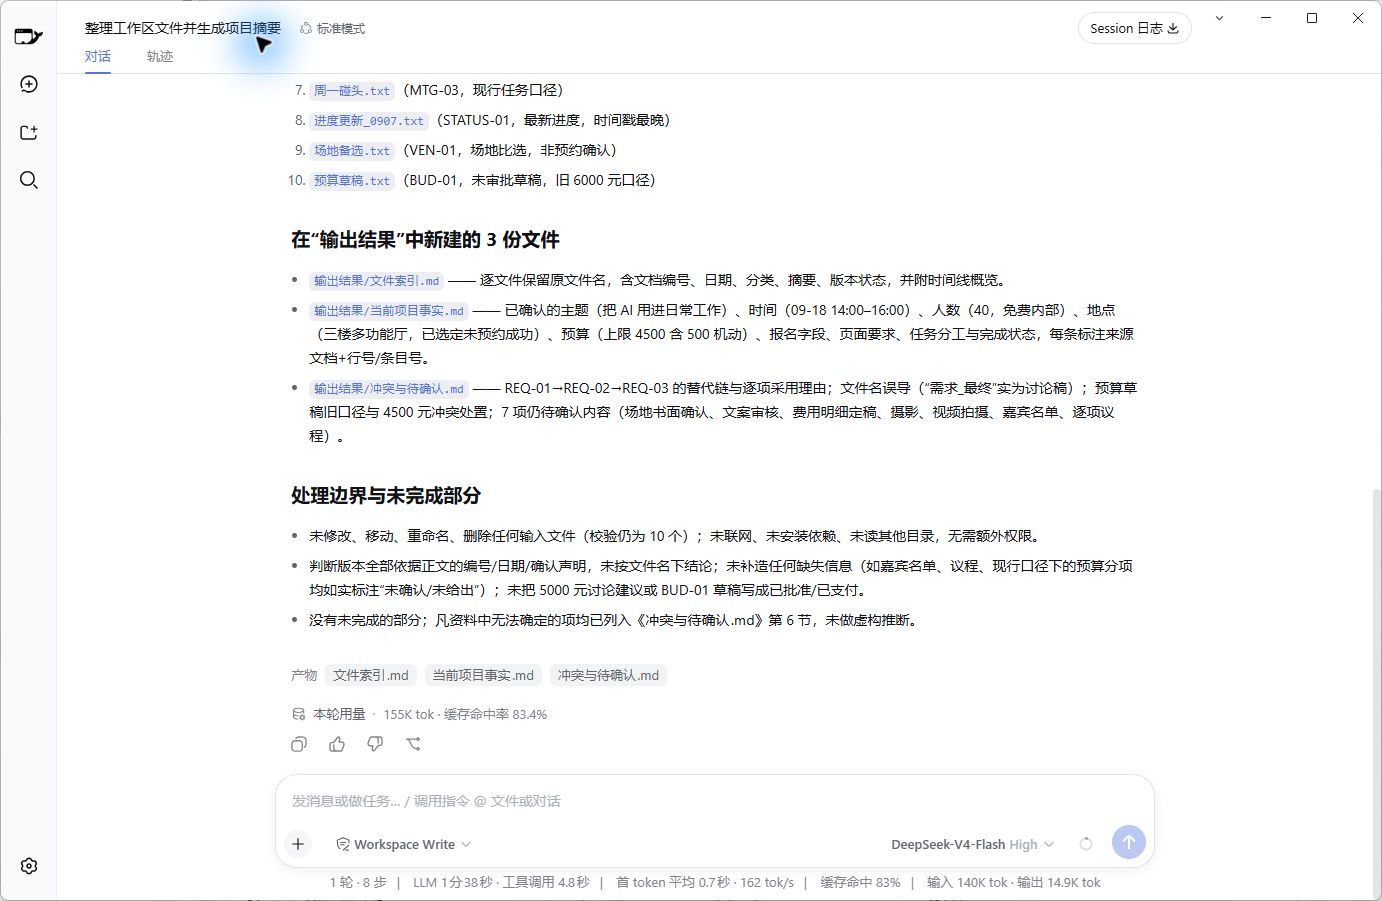
图3|本轮真实完成界面。3份文件已经生成,但完成汇报不能代替逐条验收。
问题出在参会人员。
它看到9月2日有参会名单,后两次会议没有另列名单,就自己补出“沿用同一批成员口径”。这是一种看起来顺理成章、原文却没有确认的推断。
更容易让人放松警惕的是,它后面还标了文件编号和行号。
所以我现在会把“有出处”和“出处支持这句话”分开检查。前者只是告诉我去哪里找,后者才决定这句话能不能交给同事继续用。
我会优先检查这6类词
整理几十条结果时,不可能每句话都花同样时间。我会先搜索下面这些词:
已确认、已完成、一致、全部、负责人、截止日期。
金额和具体日期也会单独查。
这些词会直接影响下一步工作。比如“建议联系刘珂”如果被写成“刘珂负责摄影”,任务就可能派错人;“选定场地”如果被写成“预约完成”,后面的人可能不再确认场地。
看到这类结论,我做三步:
1\. 打开它标出的原文件和具体位置。
2\. 看原文是否直接支持整句话,而不只是沾到其中一个词。
3\. 原文没有确认的部分,改成“未确认”,并写清楚原文到底说了什么。
这次的参会名单就是第二步出了问题。引用位置确实存在,但那里只有日期,不能支持“成员一致”。
指令写细,能让交付更好查吗
为了看清指令差别,我还用相同的10份资料跑了一个简短版本。
简短版只说明:帮我整理输入资料,让我方便查找并了解项目现状;资料没说清的地方不要猜。两组使用相同的读取和写入范围,各开新工作区,只跑一轮,没有追加纠错。
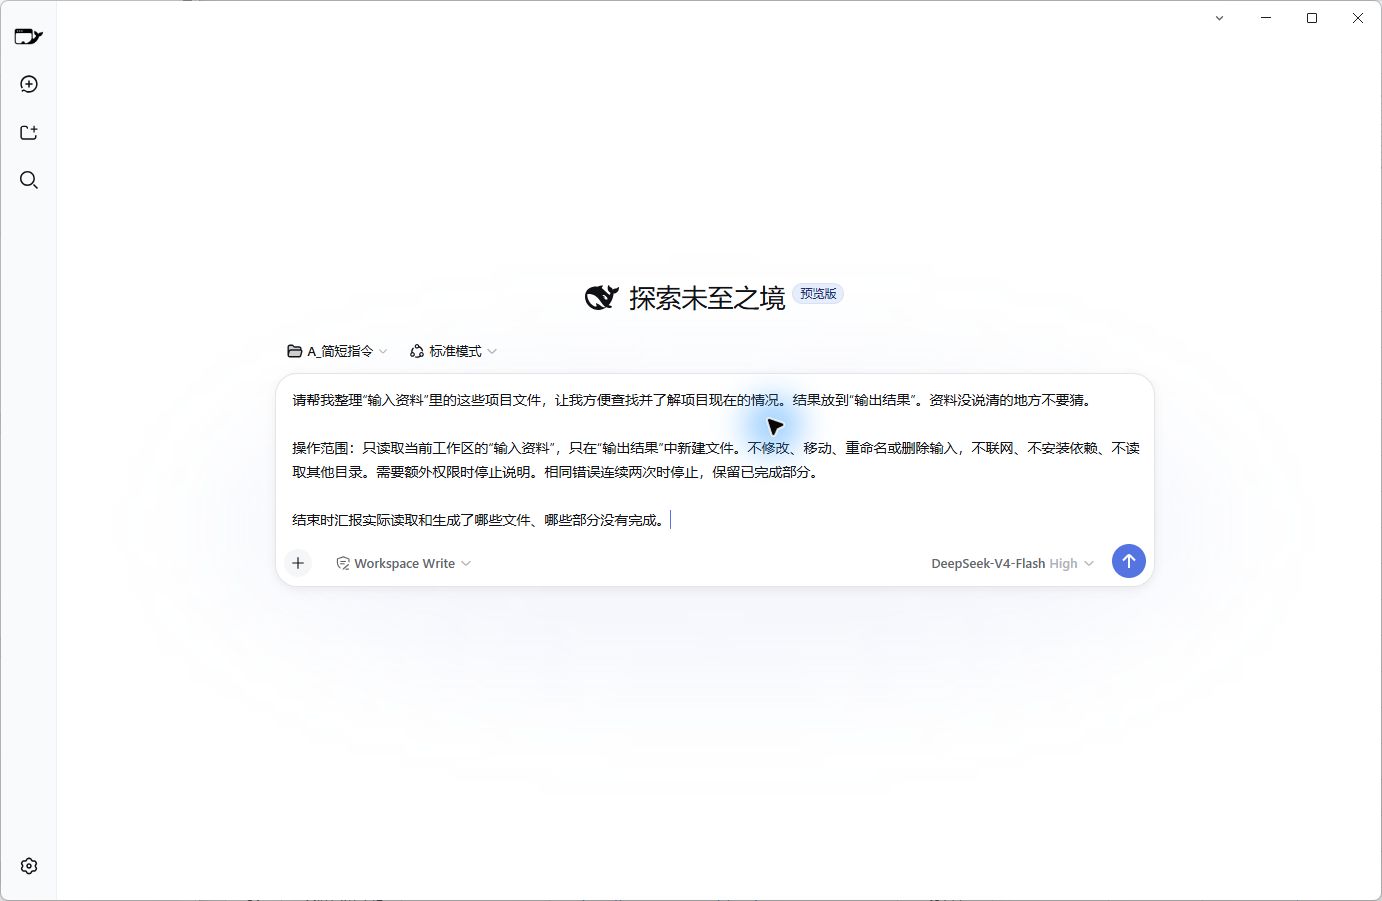
图4|简短版实际指令。操作边界和详细版相同,没有指定交付文件的数量和结构。
简短版自己生成了6份文件,详细版按要求生成3份。
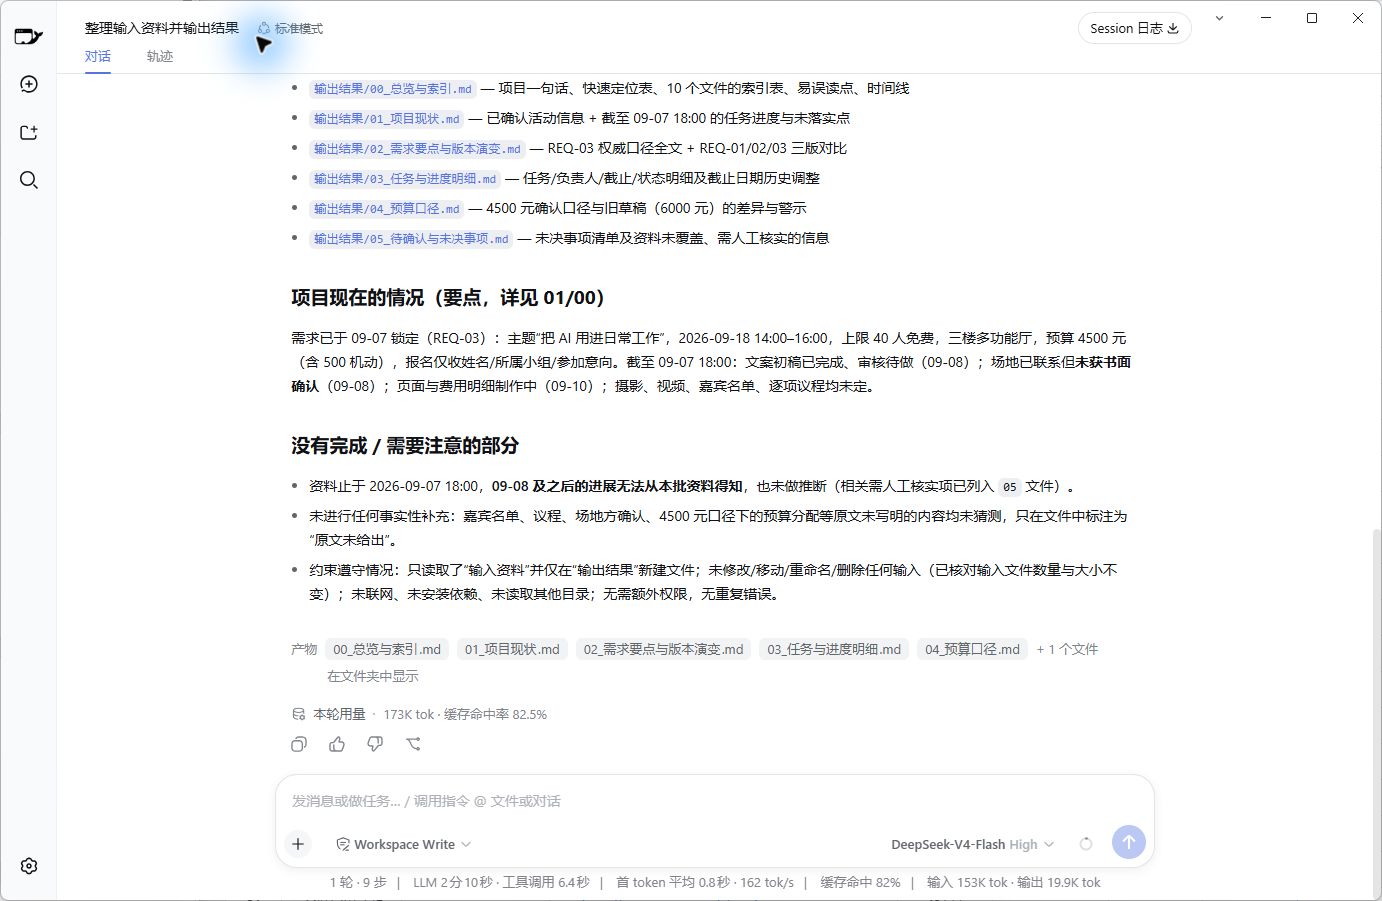
图5|简短版的真实完成界面。6份文件是工具自行安排的,不算违反任务。
对我来说,详细版更方便查找:要看现在按哪个版本执行,就打开“当前项目事实”;要看还有什么没定,就打开“冲突与待确认”。
但详细版并没有因为要求更长就完全正确。它仍然补了一条没有依据的参会人员信息。简短版也有自己的问题,它把已经给出的项目名称和正式主题,与未提供的宣传语合在一起,说成“原文均未提供”。
这两次结果说明,写清交付结构和判断规则有用,它能减少我找结果的时间。内容是否准确,仍然需要回到原文。
如果你也要让AI整理工作资料
先别急着复制一大段所谓万能提示词。你至少要把下面几件事写清楚:
• 你要解决什么问题,例如“找出当前有效版本和还没确认的事项”。
• 最后需要什么交付,例如一份当前事实和一份待确认清单。
• 出现冲突时按什么判断,例如结合确认状态、日期和明确的变更记录。
• 哪些内容不能自行补全,例如负责人、金额、完成状态和会议参与人。
• 从哪里读取、结果写到哪里,输入文件能不能修改。
生成以后,再按前面的办法查“已确认、已完成、一致、全部、负责人、截止日期”和金额。
如果时间很紧,至少核对那些会让别人立刻采取行动的结论。摘要里的形容词写得不好还能改,负责人、时间、金额和完成状态写错,可能直接把工作带偏。
这次实际用了多久
简短版界面显示2分16秒,详细版1分43秒。两次都只发送了一轮任务。
按2026年9月7日18点后的官方Flash空闲时段价格和界面用量估算,简短版约0.14元,详细版约0.11元,两次合计约0.24元。这里只计算模型用量,没有把准备材料和人工核对时间算进去。
这不是“详细指令通常更快”的结论,因为每种指令只跑了一次。真正值得留下的是这个检查习惯:AI标了出处,我仍然会打开原文,看出处是否支持整句话。
下一篇,我会用已经核对过的活动信息做一个介绍页面。资料里没有确认的嘉宾和议程继续留空,看看它做网页时能不能守住这条边界。
数界工坊|本篇是2026年9月7日的单次真实操作记录。测试资料为模拟短文本,截图均来自实际运行。

